Un model AI revoluționar cartografiază miliarde de ani de evoluție a proteinelor
O echipă internațională de cercetători, inclusiv de la Earth-Life Science Institute (ELSI) al Institutului de Știință din Tokyo, a dezvoltat un model de limbaj pentru proteine care îmbină două surse fundamentale de informație despre proteine: secvențele lor de aminoacizi și structurile tridimensionale.
Acest model oferă cercetătorilor o nouă modalitate de a cartografia relațiile din universul proteinelor și de a investiga modul în care proteinele au evoluat de-a lungul a miliarde de ani.
Cercetarea a fost coordonată de Prof. Rachel Kolodny și de studentul la doctorat Guy Yanai de la Universitatea Haifa, Prof. Nir Ben-Tal și studentul Gabriel Axel de la Universitatea din Tel Aviv, precum și de Liam M. Longo de la ELSI. Kolodny a petrecut, de asemenea, cinci luni ca cercetător invitat la ELSI, dezvoltând abordări pentru a analiza noul model. Rezultatele au fost publicate în Proceedings of the National Academy of Sciences (PNAS).
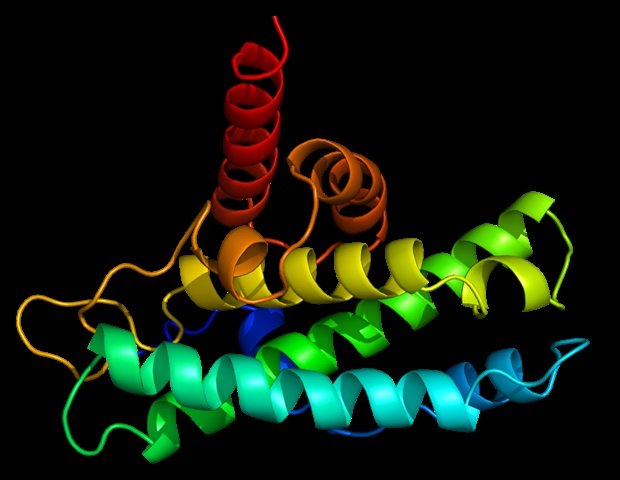
Familia proteinelor este responsabilă pentru aproape fiecare funcție din celulele vii. O întrebare fundamentală în biochimia evolutivă este cum sunt legate aceste proteine între ele și de unde provin inițial.
Cercetătorii organizează în mod tradițional proteinele în grupuri ierarhice pe baza relațiilor dintre ele, asemănător clasificărilor de gen și specie utilizate pentru organismele vii. Aceste sisteme atent curate conțin decenii de cunoștințe științifice, dar progresele în inteligența artificială creează acum noi modalități de explorare a relațiilor din vastul univers al proteinelor.
Modelele de limbaj pentru proteine pot converti o proteină într-o reprezentare numerică cunoscută sub numele de „embedding”. O modalitate de a înțelege un embedding este ca un fel de cod poștal: proteinele cu proprietăți similare tind să primească adrese apropiate. Cercetătorii pot vizualiza aceste relații pentru a produce o „hartă a lumii proteinelor”.
Există o complicație. Proteinele conțin informații atât în secvențele lor de aminoacizi, cât și în structurile lor tridimensionale, iar relația dintre cele două nu este simplă. Proteine cu secvențe complet diferite pot adopta uneori structuri similare, în timp ce secvențe similare sau chiar identice pot produce structuri foarte diferite.
Cele mai multe modele de limbaj pentru proteine au abordat secvența și structura proteinelor separat. Chiar și modelele care utilizează ambele tipuri de informație nu plasează neapărat secvența și structura aceleași proteine în aceeași locație pe o hartă a proteinelor.
Cercetătorii au dezvoltat un model numit Contrastive Learning Sequence-Structure, sau CLSS, destinat să producă embeddings foarte similare pentru reprezentările secvenței și structurii unei proteine.
CLSS folosește o abordare numită învățare contrastivă. Pe parcursul antrenamentului, modelul primește secvențe de proteine și structurile corespunzătoare și învață să producă embeddings similare pentru perechi secvență-structură, separând în același timp perechile fără legătură. Rezultatul este o hartă comună în care o reprezentare a unei proteine ocupă o locație similară pe harta lumii proteinelor, indiferent de secvența sau structura utilizată.
Comparativ cu alte modele de limbaj pentru proteine de vârf, CLSS a reușit să aducă informațiile de secvență și structură împreună într-o hartă coerentă. Reprezentările sale au reprodus, de asemenea, cu aproximație relațiile înregistrate în sistemele de clasificare a proteinelor ECOD și CATH, chiar dacă aceste clasificări nu au fost furnizate modelului în timpul antrenamentului.
Modelul a avut, de asemenea, performanțe puternice în teste de clasificare, demonstrând că combinarea informațiilor de secvență și structură poate produce reprezentări mai informative ale proteinelor.
Asta ne oferă o modalitate de a analiza universul proteinelor prin prisma secvenței și structurii simultan, în loc să le tratăm ca pe lumi separate. Ceea ce este deosebit de incitant pentru noi este posibilitatea de a folosi aceste hărți pentru a descoperi modele evolutive la scară largă care sunt dificile de recunoscut prin metode convenționale.
Liam M. Longo, Specially Appointed Associate Professor, ELSI
Majoritatea modelelor existente de limbaj pentru proteine necesită o secvență sau o structură completă pentru a produce reprezentări semnificative. CLSS a demonstrat că, în multe cazuri, fragmentele scurte de secvență pot fi plasate în mod semnificativ alături de secvențe și structuri complete.
Fragmentele de proteine sunt deosebit de importante pentru înțelegerea evoluției. Piese mici de proteine au fost reutilizate și reorganizate de-a lungul istoriei evolutive, iar unele pot fi servite chiar ca blocuri de construcție pentru cele mai vechi domenii de proteine. Fragmente similare care apar în proteine altfel diferite pot oferi, prin urmare, indicii despre relațiile evolutive antice.
Hărțile produse de CLSS au dezvăluit, de asemenea, modele mai largi în spațiul proteinelor. Când cercetătorii au suprapus proprietăți biologice pe hărți, de exemplu, proteinele asociate cu cofactori organici erau concentrate în anumite regiuni, în timp ce proteinele legate de metale erau distribuite mai larg.
Aceste modele ilustrează modul în care hărțile globale ale proteinelor pot fi utilizate nu doar pentru a clasifica proteinele, ci și pentru a explora relațiile dintre secvență, structură, funcție și istoria evolutivă a acestora.
În cele din urmă, cercetătorii își imaginează că reprezentările unificate ale secvenței și structurii deschid noi posibilități pentru căutări în baze de date, inginerie a proteinelor și reconstruirea traiectoriilor evolutive. Prin aducerea diferitelor tipuri de informații biologice în aceeași hartă, CLSS oferă o altă modalitate de a explora cum a evoluat diversitatea proteinelor găsite în viața de astăzi pe parcursul a aproape patru miliarde de ani.