AgentClinic supune inteligența artificială medicală unui test de diagnosticare mai realist
Un nou standard arată că trecerea examenelor medicale nu este suficientă; agenții AI clinici trebuie să adune informații, să gestioneze incertitudinea, să folosească instrumente, să interpreteze imagini și să navigheze prin biasuri în întâlnirile simulate cu pacienții.
Recent, un studiu publicat în revista npj Digital Medicine a introdus un benchmark multi-modal, AgentClinic, destinat agenților de inteligență artificială (AI) clinici în medii clinice simulate.
Unul dintre principalele obiective ale AI este construirea de sisteme interactive capabile să rezolve o gamă variată de probleme. Multe modele recente de limbaj de mari dimensiuni (LLMs) au reușit să rezolve probleme dificile, unele fiind provocatoare chiar și pentru oameni, și au depășit, de asemenea, scorul mediu al oamenilor la examenele de licențiere medicală. Cu toate acestea, mai multe limitări împiedică aplicarea lor în medii clinice reale.
Activitatea clinică este complexă, implicând luarea de decizii secvențiale care necesită gestionarea incertitudinii cu resurse finite și informații limitate. Această capacitate nu este reflectată în evaluările actuale, în care toate datele necesare sunt prezentate în vigneturi de caz, iar LLM-urile sunt solicitate să răspundă sau să selecteze cea mai plauzibilă opțiune.
Autorii au observat că o performanță puternică la sarcini statice de răspuns la întrebări medicale a fost doar slab predictivă pentru performanța în setările interactive ale AgentClinic. În unele cazuri, acuratețea diagnosticării a scăzut brusc când cazurile statice au fost convertite în formatul secvențial al AgentClinic.
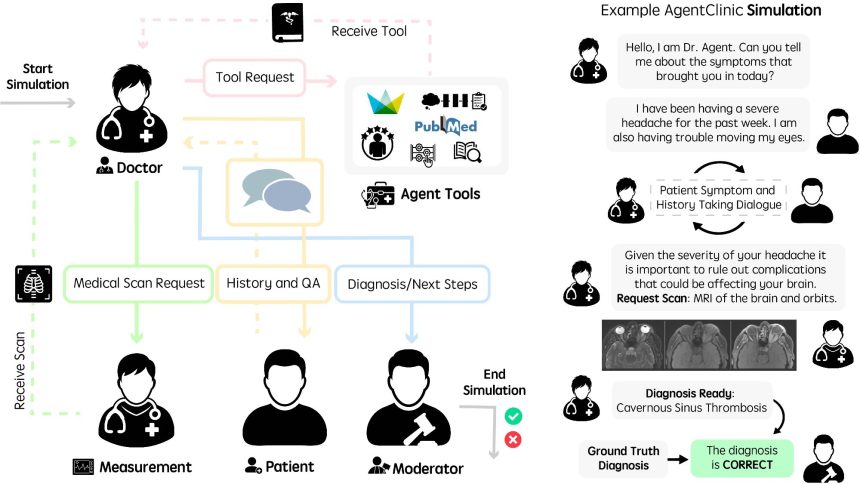
În cadrul studiului, cercetătorii au prezentat AgentClinic, un benchmark multi-modal pentru evaluarea LLM-urilor în medii clinice simulate. Benchmark-ul a inclus patru agenți de limbaj: un agent de măsurare, un agent doctor, un agent pacient și un moderator. Fiecare agent are instrucțiuni specifice și este dotat cu informații unice, indisponibile altor agenți. Agentul doctor este modelul al cărui performanță este evaluată de către ceilalți agenți.
Întrebările din setul de date MedQA, bazate pe cazuri din examenele de licențiere medicală din Statele Unite, provocările de caz din New England Journal of Medicine (NEJM) și înregistrările electronice de sănătate MIMIC-IV au fost utilizate pentru a construi agenți fundamentați pe scenarii medicale relevante. Întrebările au vizat diagnosticarea pe baza simptomelor, care au fost utilizate pentru a construi un șablon pentru prompturi.
Pentru AgentClinic-MIMIC-IV și AgentClinic-MedQA, întrebările au fost selectate din seturile de date MIMIC-IV și MedQA, respectiv. Un fișier de intrare structurat conținând informațiile cazului a fost generat folosind GPT-4, iar scenariile de caz au fost validate manual. În general, agentul doctor a primit un obiectiv; agentul pacient a primit simptomele și istoricul pacientului; agentul de măsurare a primit rezultatele examenului fizic; iar moderatorul a primit diagnosticul corect.
Acuratețea a 11 LLM-uri a fost evaluată pe AgentClinic-MedQA, fiecare acționând ca agent doctor pentru a diagnostica agentul pacient (GPT-4) prin dialog. Au fost permise douăzeci de interacțiuni între agentul doctor și agenții pacient și de măsurare înainte de a formula un diagnostic. În plus, performanța a trei medici umani a fost evaluată folosind aceleași constrângeri și instrucțiuni, deși acest eșantion mic de clinicieni trebuie interpretat cu precauție. Claude 3.5 Sonnet a demonstrat cea mai mare acuratețe de 62,1%, urmat de OpenBioLLM-70B (58,3%) și de medici (54%).
Acuratețea pe AgentClinic-MIMIC-IV a fost cea mai mare pentru Claude 3.5 Sonnet (42,9%), urmat de GPT-4 (34%) și GPT-3.5 (27,5%). Reducerea numărului de interacțiuni la 10 a dus la o scădere semnificativă a acurateței la 25%, iar creșterea acestuia la 30 de interacțiuni a dus, de asemenea, la o scădere a acurateței. Acuratețea agentului doctor a variat în funcție de agentul pacient; agenții pacienți GPT-4 au obținut o acuratețe mai mare decât cei Mixtral-8x7B sau GPT-3.5.
Acuratețea diverselor modele de limbaj doctor și a medicilor umani pe AgentClinic-MedQA utilizând agenți pacienți și de măsurare GPT-4 (stânga). Acuratețea GPT-4 pe AgentClinic-MedQA în funcție de modelul de limbaj al pacientului (mijloc). Acuratețea pe AgentClinic-MIMIC-IV în funcție de numărul de agenți pacienți și de măsurare GPT-4 (dreapta).
Următorii, cercetătorii au evaluat impactul a șase instrumente ale agenților asupra acurateței diagnostice: Reflection Chain-of-Thought (CoT), Notebook, Zero-Shot CoT, Generarea Augmentată de Recuperare Adaptivă folosind surse de manuale, Generarea Augmentată de Recuperare Adaptivă folosind surse web și One-Shot CoT. Claude 3.5 Sonnet a demonstrat cea mai bună performanță cu acurateți medii și maxime de 51,3% și 56,1%, respectiv, utilizând instrumentul Notebook. GPT-4o și GPT-4 au obținut îmbunătățiri moderate în majoritatea instrumentelor, dar utilizarea instrumentelor nu a fost uniform benefică pentru toate modelele.
De asemenea, biasurile implicite (asociații inconștiente influențate de norme culturale și sociale, de exemplu, biasul de gen) și biasurile cognitive (modele sistematice de deviație de la raționalitate sau norme în judecată, de exemplu, biasul de recență) au fost incluse în prompturi pentru a evalua efectele asupra acurateței diagnostice. Pentru GPT-4, acuratețea a scăzut la 48% și 50,3% pentru biasurile cognitive ale pacientului și doctorului și la 51,3% și 50,5% pentru biasurile implicite ale pacientului și doctorului, respectiv. Benchmark-ul a evaluat, de asemenea, încrederea pacienților simulați, conformitatea cu tratamentele și disponibilitatea de a consulta din nou același doctor, dar aceste evaluări au fost realizate de pacienți simulați de LLM-uri, nu de pacienți reali.
Apoi, echipa a examinat cazurile de specialitate folosind întrebări de raport de caz din nouă specialități medicale din setul de date MedMCQA. Constant, Claude 3.5 Sonnet a fost modelul cu cea mai bună performanță, având o acuratețe medie diagnostică de 66,7%, demonstrând o performanță puternică în medicina internă, otorinolaringologie și ginecologie. Performanța a variat în funcție de specialitate, sugerând că diagnosticul bazat pe dialog poate diferi de testele medicale statice cu răspunsuri multiple. În continuare, echipa a evaluat patru LLM-uri multi-modale într-un cadru de diagnosticare care a necesitat, de asemenea, înțelegerea citirilor de imagini.
Cercetătorii au evaluat, de asemenea, cazuri multilinguale în șapte limbi: engleză, chineză, franceză, spaniolă, hindi, persană și coreeană. Cele mai multe modele au obținut cele mai bune rezultate în engleză și au arătat o variabilitate substanțială în alte limbi, în timp ce Claude 3.5 Sonnet a menținut cea mai bun