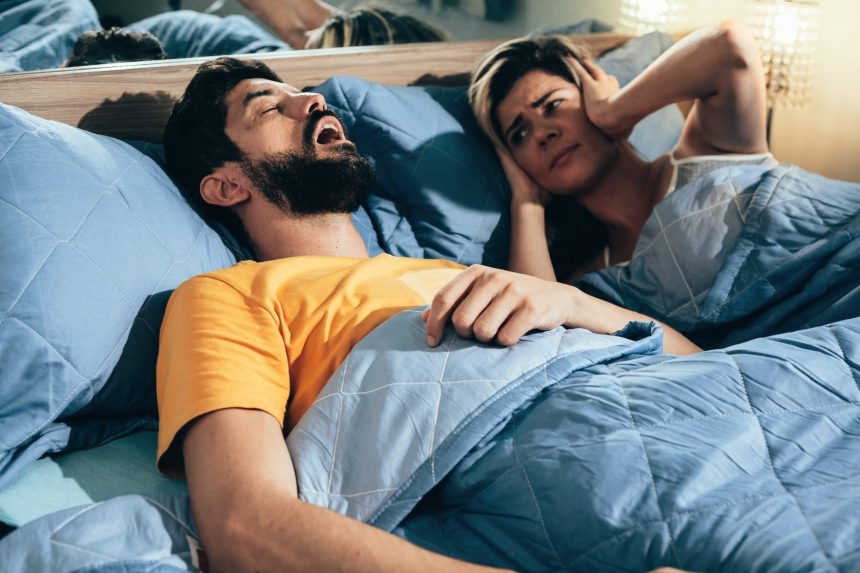
Un model AI identifică locul de început al sforăitului în căile respiratorii
Prin transformarea sunetelor de sforăit în imagini timp-frecvență, cercetătorii au dezvoltat un sistem AI ușor, care ar putea ajuta la localizarea mai precisă a obstrucției căilor respiratorii superioare, deși testarea clinică în condiții reale rămâne următoarea provocare.
Într-un recent „Articol în Presă” publicat în revista Scientific Reports, cercetătorii au propus un cadru de integrare heterogen pentru clasificarea surselor de sforăit.
Sforăitul este un simptom principal asociat cu apneea obstructivă în somn, cauzată de obstrucția sau vibrația structurilor căilor respiratorii superioare, inclusiv epiglota, baza limbii, pereții orofaringieni laterali și palatul moale. Originea anatomică a sforăitului poate fi identificată noninvaziv prin clasificarea semnalelor audio de sforăit. Cu toate acestea, metodele actuale de clasificare se confruntă cu dificultăți din cauza datelor limitate, integrării slabe a informațiilor timp-frecvență și distribuției dezechilibrate a claselor.
În cadrul studiului prezent, cercetătorii au propus un cadru de integrare heterogen pentru clasificarea surselor de sforăit. Acest cadru cuprinde trei module esențiale: generarea spectrogramelor bazate pe transformata Fourier pe termen scurt (STFT), extragerea caracteristicilor prin rețele neuronale convoluționale (CNN) preantrenate și clasificarea prin mașini cu vectori de suport (SVM). Astfel, STFT generează spectrograme convertind semnalele audio de sforăit, păstrând informațiile timp-frecvență.
Mai mult, caracteristicile de înalt nivel timp-frecvență sunt extrase din spectrograme utilizând CNN-uri preantrenate. În cele din urmă, un clasificator SVM este antrenat pe caracteristicile extrase pentru a clasifica semnalele audio de sforăit în patru categorii. Echipa a testat modelul pe corpusul de sunete de sforăit Munich-Passau (MPSSC). Acest corpus a inclus înregistrări de sforăit din palatul moale, baza limbii, epiglota și pereții orofaringieni laterali, clasificate ca V, T, E și O, respectiv.
Echipa a împărțit setul de date MPSSC în seturi de antrenament, dezvoltare și testare. Exemplele audio ale acestor clase de sforăit erau distribuite inegal în setul de antrenament, cu exemplele clasei V reprezentând 56,9% și cele ale clasei E 10,7%. Prin urmare, a fost adoptată o metodă de upsampling pentru a uniformiza numărul de exemple. Apoi, echipa a aplicat STFT cu o fereastră de 512 eșantioane la o rată de eșantionare de 44,1 kHz pentru a genera spectrograme.
Spectrogramele au fost redimensionate pentru a îndeplini cerințele de intrare ale două CNN-uri preantrenate, VGG19 și AlexNet, iar caracteristici de 4096 de dimensiuni au fost extrase din straturile complet conectate 6 (fc6) și 7 (fc7). În plus, un SVM regularizat L2 a fost antrenat pe caracteristicile extrase. Combinarea AlexNet fc7 cu harta de culori Viridis a fost identificată ca fiind cea mai performantă, având un recall mediu neponderat (UAR) de 46,0% și 67,1% pe seturile de dezvoltare și testare, respectiv.
Pentru a evalua contribuția fiecărui component în cadru, au fost efectuate analize de ablație prin modificarea sau excluderea modulelor individuale, menținând celelalte condiții neschimbate. Eliminarea STFT și substituirea spectrogramelor cu reprezentări de imagini bazate pe undă au redus UAR la 54,3%, o scădere de 12,8 puncte procentuale, ceea ce indică faptul că informațiile explicite timp-frecvență sunt esențiale pentru extragerea caracteristicilor.
În plus, a fost înregistrată o scădere de 7,5 puncte procentuale în performanță atunci când SVM a fost înlocuit cu un strat complet conectat fin ajustat, subliniind importanța alegerii clasificatorului. În mod notabil, înlocuirea CNN-ului preantrenat cu caracteristici realizate manual a redus UAR cu 21,3 puncte procentuale. Apoi, echipa a evaluat eficacitatea cadrului propus în raport cu diverse metode convenționale.
Printre acestea s-au numărat coeficienții cepstrali de frecvență Mel cu SVM (MFCC + SVM), CNN end-to-end, CNN-memorie pe termen lung și scurt (LSTM), unitatea recurentă convoluțională duală (DualConvGRU), transformatorul de spectrogramă audio (AST), WavLM și wav2vec 2.0. Aceste metode au fost evaluate pe aceleași seturi de antrenament, dezvoltare și testare ale MPSSC.
Majoritatea metodelor au arătat un UAR mai mare pe setul de testare decât pe cel de dezvoltare, cadrul propus realizând cea mai mare îmbunătățire (21,1 puncte procentuale). În plus, cadrul propus a depășit MFCC+SVM, indicând că caracteristicile acustice realizate manual nu reușesc să capteze modelele complexe din semnalele audio de sforăit. De asemenea, a raportat un UAR ușor mai mare pe setul de testare decât CNN-ul end-to-end.
DualConvGRU a avut un UAR mai mare pe setul de dezvoltare decât cadrul propus, dar îmbunătățirea sa de la setul de dezvoltare la setul de testare a fost de doar 8,8 puncte procentuale. Modelul propus a raportat, de asemenea, UAR-uri mai mari pe setul de testare decât modelele avansate de audio, cum ar fi WavLM, AST și wav2vec 2.0. În cele din urmă, într-o analiză a matricei de confuzie, modelul DualConvGRU a arătat o confuzie semnificativă între clasele V și O, în timp ce cadrul propus a realizat un profil de recall mai echilibrat, deși clasa O a rămas provocatoare, iar recall-ul clasei T a scăzut.
În concluzie, studiul a descris un model de clasificare a sforăitului bazat pe spectrograme STFT, extragerea caracteristicilor prin CNN-uri preantrenate și clasificarea SVM; a atins un UAR de 67,1% pe setul de testare MPSSC, cea mai mare valoare raportată dintre metodele comparate. Eliminarea oricărui modul a dus la o scădere a UAR de la 7,5 la 21,3 puncte procentuale, subliniind rolurile complementare ale modulelor. Studiile ulterioare sunt necesare pentru a valida independent acest model pe seturi de date clinice externe și pentru a îmbunătăți generalizabilitatea și robustetea sa.